
Las pruebas de integración extremo a extremo (E2E) con Selenium sobre entornos corporativos complejos —como bases de datos en preproducción de banca— presentan un desafío crítico: la gestión del estado de los datos.
Cuando múltiples casos de prueba interactúan con entidades de negocio (por ejemplo, personas y contratos), los tests tienden a «quemar», modificar o corromper el estado inicial. Limpiar y recrear grandes volúmenes de datos en una base de datos corporativa pesada destruye el rendimiento de las pipelines de CI/CD.
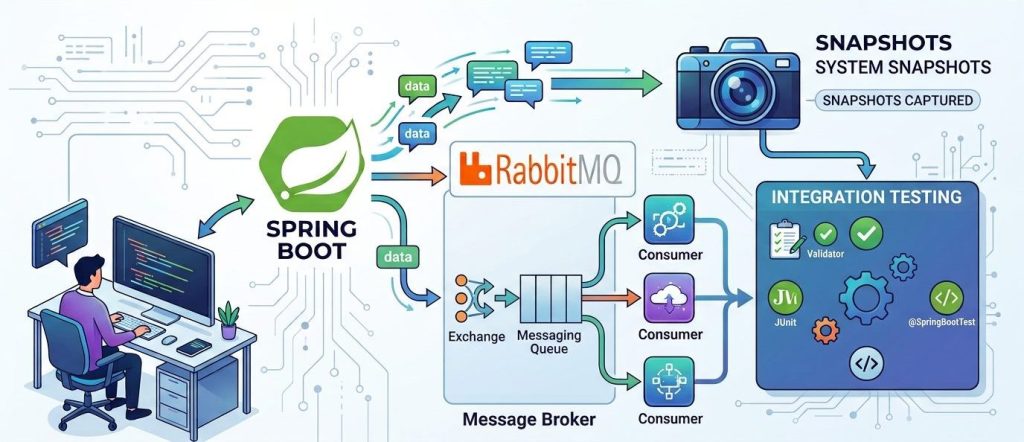
Para solucionar este problema de forma elegante, escalable y desacoplada, diseñé e implementé una herramienta interna basada en eventos y arquitectura de snapshots. A continuación, te detallo cómo está construida por dentro.
1. El Enfoque Conceptual: Planchado Selectivo
En lugar de intentar clonar o resetear bases de datos enteras (lo cual es inviable por tamaño y bloqueos), el sistema realiza un «planchado» (snapshot quirúrgico):
- Cada caso de prueba define exactamente los recursos que necesita (de 0 a N personas y de 0 a N contratos).
- El sistema clona de forma aislada solo esos registros hacia una base de datos espejo en PostgreSQL, manteniendo exactamente la misma estructura de tablas y campos.
2. Arquitectura y Componentes del Sistema
Todo el ecosistema se estructuró de forma modular y se empaquetó mediante Docker Compose para garantizar una ejecución portátil tanto en local como en servidores de integración. La arquitectura consta de los siguientes bloques:
- Base de Datos PostgreSQL (Datos Planchados): Almacena la estructura espejo (tablas y campos idénticos a los datos de negocio) correspondientes a las personas y contratos capturados en el snapshot.
- Microservicio Gestor de Snapshots (Spring Boot): Conectado a RabbitMQ, es el componente encargado de escuchar las peticiones para crear, recrear y restaurar los snapshots de forma atómica.
- Base de Datos de Test Cases: Almacena la metainformación de los casos de prueba, incluyendo el identificador de cada test y la correspondencia exacta de los datos que requiere.
- Microservicio Orquestador (Spring Boot): Controla el ciclo de vida de los test cases y se encarga del lanzamiento de los eventos hacia RabbitMQ para disparar la creación o restauración de los estados.
- Frontend (Angular): Una interfaz de usuario limpia e intuitiva para la consulta, creación y eliminación de test cases, que interactúa directamente con el microservicio orquestador (punto 4).
- Módulo de Importación/Exportación (Spring Batch): Dos jobs de Spring Batch expuestos mediante REST API. Permiten importar y exportar los datos tanto de los snapshots como de los test cases. Dado que la aplicación se ejecuta en local, los ficheros de intercambio se comparten de forma centralizada.
3. Escalabilidad mediante Arquitectura Orientada a Eventos (EDA)
Una de las mayores ventajas de este diseño es su desacoplamiento. Al utilizar RabbitMQ como bus de eventos entre el orquestador y el gestor de snapshots, la infraestructura está preparada para crecer de manera transparente:
Si en el futuro se necesita incorporar nuevas bases de datos o entidades a planchar, basta con añadir un nuevo consumidor acoplado a la cola de RabbitMQ sin alterar la lógica de negocio de los tests ni el frontend.
Conclusión
Construir herramientas de desarrollo (Internal Developer Tooling) adaptadas a las restricciones de entornos corporativos no solo acelera el trabajo diario de los equipos de QA y desarrollo, sino que demuestra cómo aplicar principios de arquitectura de microservicios, mensajería asíncrona (RabbitMQ) y procesamiento por lotes (Spring Batch) a problemas reales del día a día.
¿Te has enfrentado a retos similares en tus entornos de integración? ¡Te leo en los comentarios!


Deja una respuesta